Kit by Speakeasy 测评:定位开发者的 AI 编码代理运行时,优缺点与替代品分析
面向中文开发者的 Kit by Speakeasy 评测:先给结论,再拆解定位、核心能力、适合谁、局限与价格风险,附带替代品方向与试用建议。
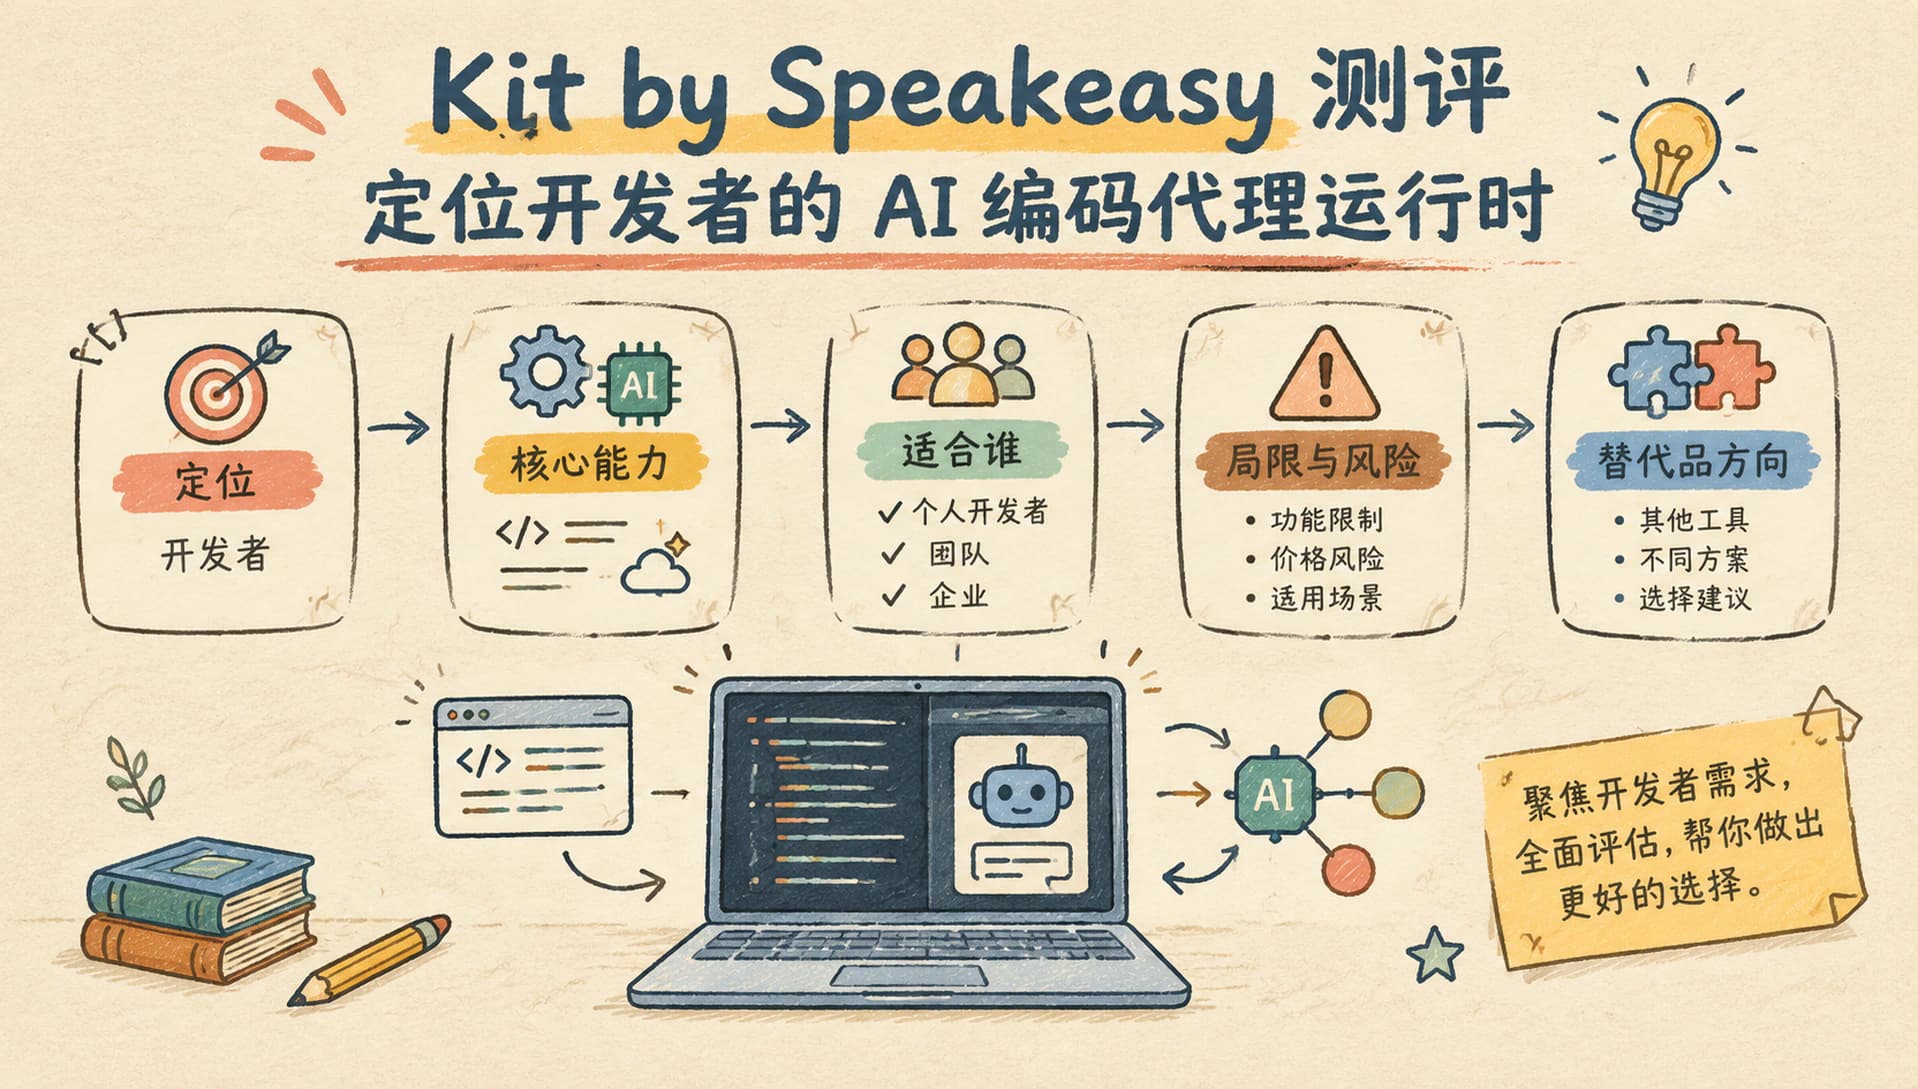
一句话结论:Kit by Speakeasy 把自己定位成“开发者的 AI 编码代理运行时”,主打“Claude 思路,但更快、更便宜、更简洁”。如果你已经在用 LLM 跑代码生成,这套东西属于工程化封装层,而不是基础模型本身。
先把产品定位说清楚。Speakeasy 此前以 API SDK 生成见长,这次的 Kit 把重点放在“编码代理运行时”。换句话说,它要解决的问题不是“模型能不能写代码”,而是“如何把模型稳定地塞进开发流程里”。这层封装通常关心延迟、成本、可重复执行和安全边界。
核心功能可以从原始摘要拆出三条线索:第一,更快,意味着对响应速度和首字时间做了优化;第二,更便宜,意味着在 token 调用和上下文管理上做了压成本设计;第三,更简洁,意味着输出更短、更结构化,方便接入 CI/CD 或编辑器插件。但这些都是官网口径,实测数据需要读者自行验证。
证据边界需要提前说。Product Hunt 页面是发布与社区讨论入口,不是性能基准报告。任何关于“X 倍速度”“Y 成本节省”的描述,目前都只能当作厂商主张。本文也不补充虚构的实测数字,避免误导选型。
适合谁与不适合谁
适合谁主要有三类:一是已经在用 Claude 或类似模型做代码生成,想把调用成本和延迟压下去的小团队;二是需要把 AI 编码能力接入内部工具链、构建插件或代理产品的工程团队;三是希望以“运行时”而非“模型”为单位做技术选型的技术负责人。
不适合谁也要提一下。如果你只是想找一个聊天式写代码助手,Kit 这类运行时对你来说“过度工程化”;如果你的核心痛点是模型本身能力不够,那应该先看基础模型版本,再考虑运行时;如果是个人学习用途,免费 IDE 插件通常更划算。
核心能力拆解
Kit 的能力可以拆成四个维度来理解。第一是代理执行层,让模型不仅能“写代码片段”,还能跑起完整任务步骤;第二是上下文管理,决定长任务的成本和稳定性;第三是输出精简,把模型的话痨倾向压到工程可用的粒度;第四是对 Claude 这类上游模型的依赖与适配。
需要注意,这些维度来自产品定位描述,不是第三方评测。读者在试用时,建议重点验证:响应延迟、token 消耗曲线、复杂任务的失败率,以及和现有编辑器或 CI 流程的兼容性。
优点、缺点与价格限制
先说优点。定位清晰,聚焦“运行时”这一层,避免和基础模型厂商正面竞争;强调成本与延迟,回应了开发者最在意的两个指标;背靠 Speakeasy 的 SDK 经验,工程集成门槛相对可控。
缺点也不能回避。对上游模型高度依赖,一旦上游涨价或限速,运行时会跟着波动;生态尚新,社区案例和文档深度未必成熟;中文场景下的代码生成质量、注释风格、依赖推荐是否一致,没有公开数据可参考。
价格和限制方面,原始信息只给出“更便宜”的方向感,没有给出具体套餐、配额或企业版细节。结论是:定价以官网为准,不要被社区帖里的估算数字带跑。
替代品方向
如果你的目标是“更快更省的 AI 编码体验”,不一定要锁死 Kit。常见替代方向有三类:一是模型层面的替代,比如直接切换到不同档位的 Claude、GPT 系列或其他开源代码模型;二是IDE 与插件替代,比如 Cursor、Continue、Tabby 这类把模型嵌入编辑器的方案;
三是代理与编排框架,比如 LangChain、LlamaIndex 的代理模块,以及各类自托管代理运行时。
选哪个,取决于你卡在哪一层。模型层卡就换模型;编辑器体验卡就换 IDE 插件;流程自动化卡就换运行时或编排框架。下面这张对比表,可以作为粗筛参考。
产品与替代方案对比
在选型时,把 Kit 与常见替代品放到同一张表里看更直观。需要强调:表格中的能力描述基于各自官方定位与社区讨论,具体表现以实际试用为准。
| 维度 | Kit by Speakeasy | 模型层替代(Claude/开源代码模型) | 编辑器替代(Cursor/Continue/Tabby) | 编排框架替代(LangChain/LlamaIndex) |
|---|---|---|---|---|
| 解决的主要问题 | 编码代理运行时与成本控制 | 模型能力本身 | 编辑器内的代码补全与对话 | 多步骤代理与外部工具编排 |
| 成本控制重点 | 调用与上下文压缩 | 看具体套餐和档位 | 订阅制为主 | 自托管可压成本 |
| 集成难度 | 中等,需工程化接入 | 低,直接调用 API | 低,插件安装 | 中高,需自行搭建 |
| 适合场景 | 团队内自动化代理 | 通用代码生成 | 个人或小团队日常编码 | 复杂工作流与多工具联动 |
| 主要风险 | 依赖上游模型与生态成熟度 | 受限于模型能力上限 | 体验绑定较深 | 维护成本与稳定性 |
试用与选型建议
试用前先回答两个问题:你卡在模型层、编辑器层还是运行时层?这三个层的替代方案互不重叠,方向选错会浪费时间。
建议的试用顺序:第一步,去 Product Hunt 页面和官网看产品演示与文档,确认“运行时”定位是否符合预期;第二步,用一个真实的小任务跑通接入,记录延迟和 token 消耗;第三步,把它和你当前方案在同一个任务上对比,再判断是否值得切换。
如果你只是个人开发者,先用免费或低成本的编辑器插件更稳妥;如果是团队要把 AI 编码做成内部工具,Kit 这类运行时值得花时间评估;如果是企业采购,还要额外关注数据合规、审计日志和私有化部署能力——这些在原始信息里没有提到,必须问清楚供应商。
同主题阅读路径
查看「工具测评」栏目本文相关工具推荐
以下工具包含官网、适用场景和参考链接。购买或订阅前建议核对最新价格、功能和服务条款。
Kit by Speakeasy
面向中文开发者的 Kit by Speakeasy 评测:先给结论,再拆解定位、核心能力、适合谁、局限与价格风险,附带替代品方向与试用建议。
- - AI 工具评估
- - 个人或团队试用
读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具