Revalvo 测评:多模型提示词跑分工具优缺点、适合谁与替代品
Revalvo 面向需要在多个大模型间批量对比输出的开发者和产品团队,主打分、版本、发布一体化,但价格与覆盖信息有限,建议以官网为准。
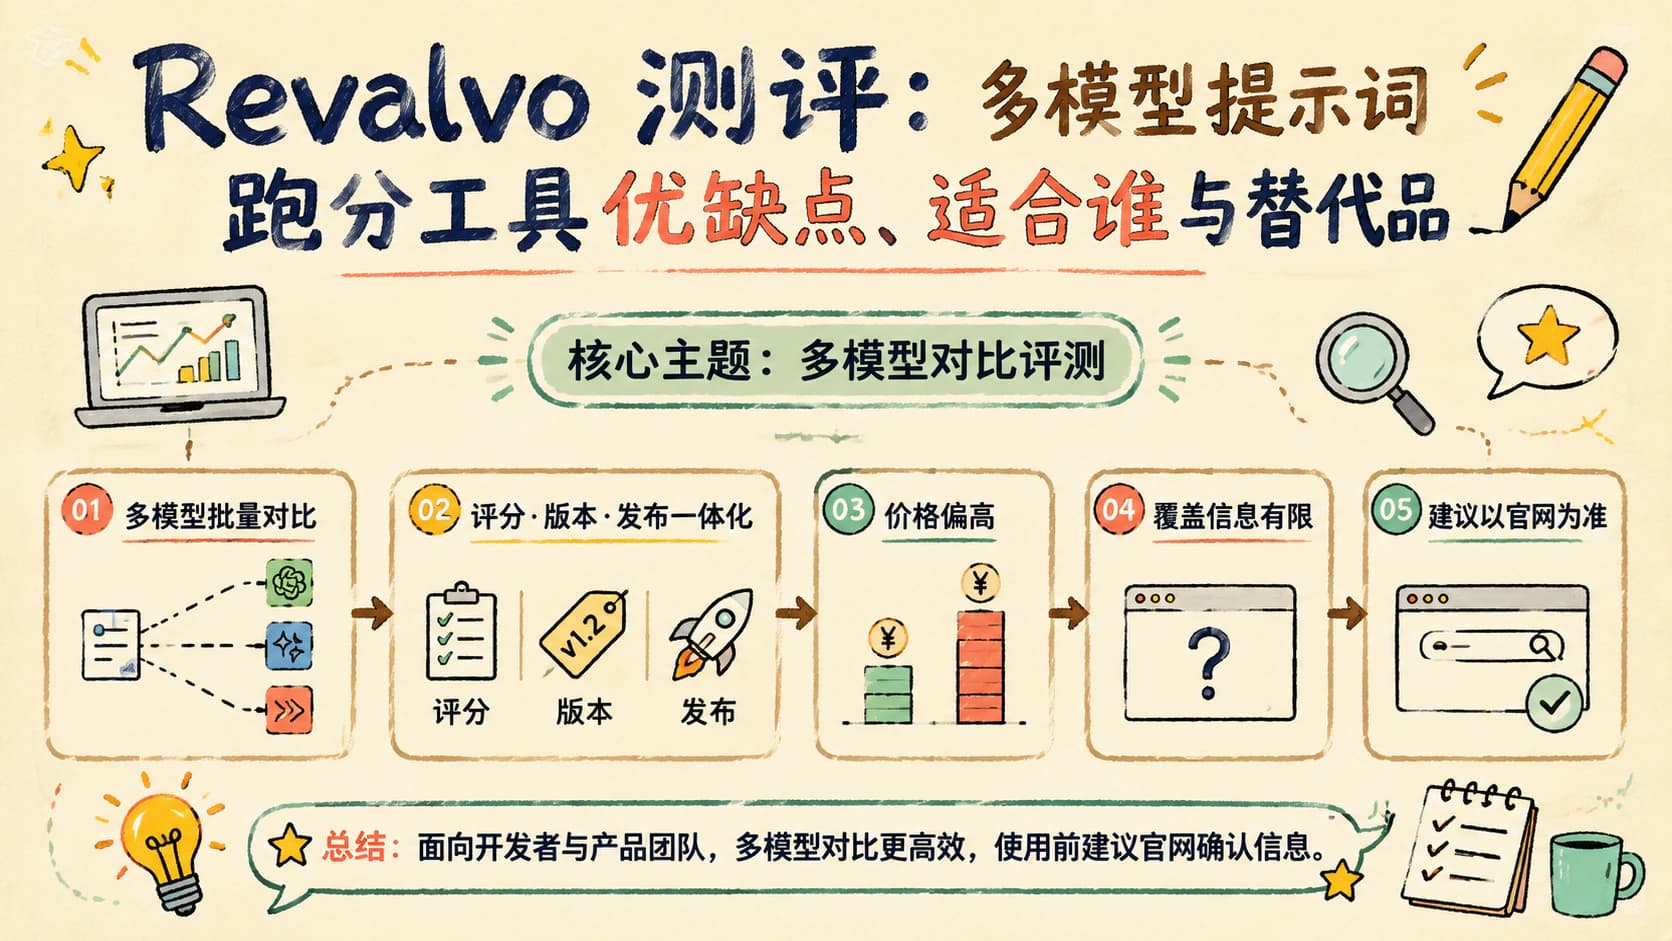
一句话结论:Revalvo 把「同时跑多个模型、给输出打分、保留历史版本」压进同一条工作流。对需要批量评估模型表现的团队值得一试,但个人轻度用户大概率用不上完整功能。
产品定位
Revalvo 的英文描述很短——Run prompts on every model at once. Score. Version. Ship. 从这句口号看,它瞄准的是 prompt 工程师和模型评测人员:解决在 GPT、Claude、Gemini 之间反复切换、手动复制结果、自己做对比的繁琐流程。
它的定位不是聊天机器人,也不是通用 AI 工作台,而是 多模型并行评测与版本管理工具。目标用户是对 prompt 调优敏感、需要在多模型间做横向对比的内容团队和开发者。
核心功能与证据边界
从可获取的公开信息看,Revalvo 至少包含三块能力:多模型同时跑同一个提示词、对输出结果做评分或排序、保存和回溯历史版本。这套组合在 prompt 迭代场景里很实用。
不过能接入哪些模型、评分机制是 AI 自动还是人工标注、版本对比如何展示,这些细节在公开页面没有完整披露。读者在试用前应以官网文档为准,不要仅凭一句口号就下结论。
适合谁 / 不适合谁
如果你的工作流是「写一个 prompt → 在 3 个以上模型上跑 → 挑最好的输出 → 反复迭代」,Revalvo 的设计刚好对位。内容团队负责人、AI 产品经理、做模型选型的工程师都可能从这类工具里省时间。
如果只是偶尔问 ChatGPT 一个问题,或者只在一个模型上做开发,多模型并行能力基本是浪费,直接用各家官方 Playground 即可。对数据合规要求极高、必须本地化部署的企业,也需要先评估云端 SaaS 的隐私策略。
优点与缺点
优点在于:并行跑提示词压缩评测时间,省去手动复制粘贴;版本管理让 prompt 迭代历史可追溯,团队协作不会丢上下文;一站式设计降低了在不同工具间跳转的心智负担。
缺点在于:公开信息有限,价格、企业版能力、API 限额都不透明;新工具稳定性通常不如成熟产品,长期使用前建议先在小项目里试跑。如果评分机制依赖 AI 自动判定,对严肃评测来说可信度需要打折扣。
价格、限制与替代品
Product Hunt 页面没有列出价格细节,订阅模式、按量计费还是企业询价都待确认。读者应以官网最新说明为准,不要依赖第三方转述。
| 维度 | Revalvo | PromptLayer | LangSmith | 官方 Playground |
|---|---|---|---|---|
| 多模型并行 | 从描述看支持 | 部分支持 | 部分支持 | 单模型为主 |
| 版本管理 | 强调 versioning | 强调 tracing | 强调 tracing | 较弱 |
| 自动评分 | 强调 score | 支持 | 支持 | 多数不支持 |
| 适合团队 | 是 | 是 | 是 | 个人为主 |
| 价格透明度 | 待确认 | 公开 | 公开 | 免费 |
选择建议:如果核心需求是横向打分,Revalvo 和 PromptLayer 更贴近;如果更看重链路追踪和调试,LangSmith 更成熟;如果只是临时对比,免费 Playground 就够用。预算紧、追求稳定的团队,目前更稳妥的选择仍是已有几年积累的产品。
试用建议
第一步到官网注册账号,用免费额度跑 5 到 10 个真实业务 prompt,重点验证自动评分结果是否与人工判断一致。第二步把版本历史和团队协作功能各走一遍,确认是否满足长期使用。第三步再根据实际使用量决定是否付费。
在尚未确认隐私策略前,不建议把核心客户数据直接喂给新工具。先用脱敏数据试水,是更稳妥的做法。如果两周内体验不到明显效率提升,可以暂缓付费,继续观察后续版本。
同主题阅读路径
查看「工具测评」栏目本文相关工具推荐
以下工具包含官网、适用场景和参考链接。购买或订阅前建议核对最新价格、功能和服务条款。
Revalvo
Revalvo 面向需要在多个大模型间批量对比输出的开发者和产品团队,主打分、版本、发布一体化,但价格与覆盖信息有限,建议以官网为准。
- - AI 工具评估
- - 个人或团队试用
读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具